引言:在长记忆 Agent 架构中,最常见的瓶颈往往出在检索上:向量召回虽然能圈出大致范围,但排在前面的往往不是核心事实;全塞进 Prompt 会导致上下文爆炸,而让大模型做重排(Rerank)单次就要等 2 秒以上。
本文是 《Jev 实战与落地系列》的第一篇,聚焦如何利用新型非自回归模型 Jev 作为 Agent 的“小脑”,实现毫秒级记忆重排与 Prompt 60% 的深度瘦身。
一、检索召回的两难困境:塞多了卡,重排更卡
在自托管 Agent 记忆库(如基于向量数据库、Mem0 等)的工程实践中,普遍存在一个两难矛盾:
- 密集向量(Embedding)能粗排,但排不准:
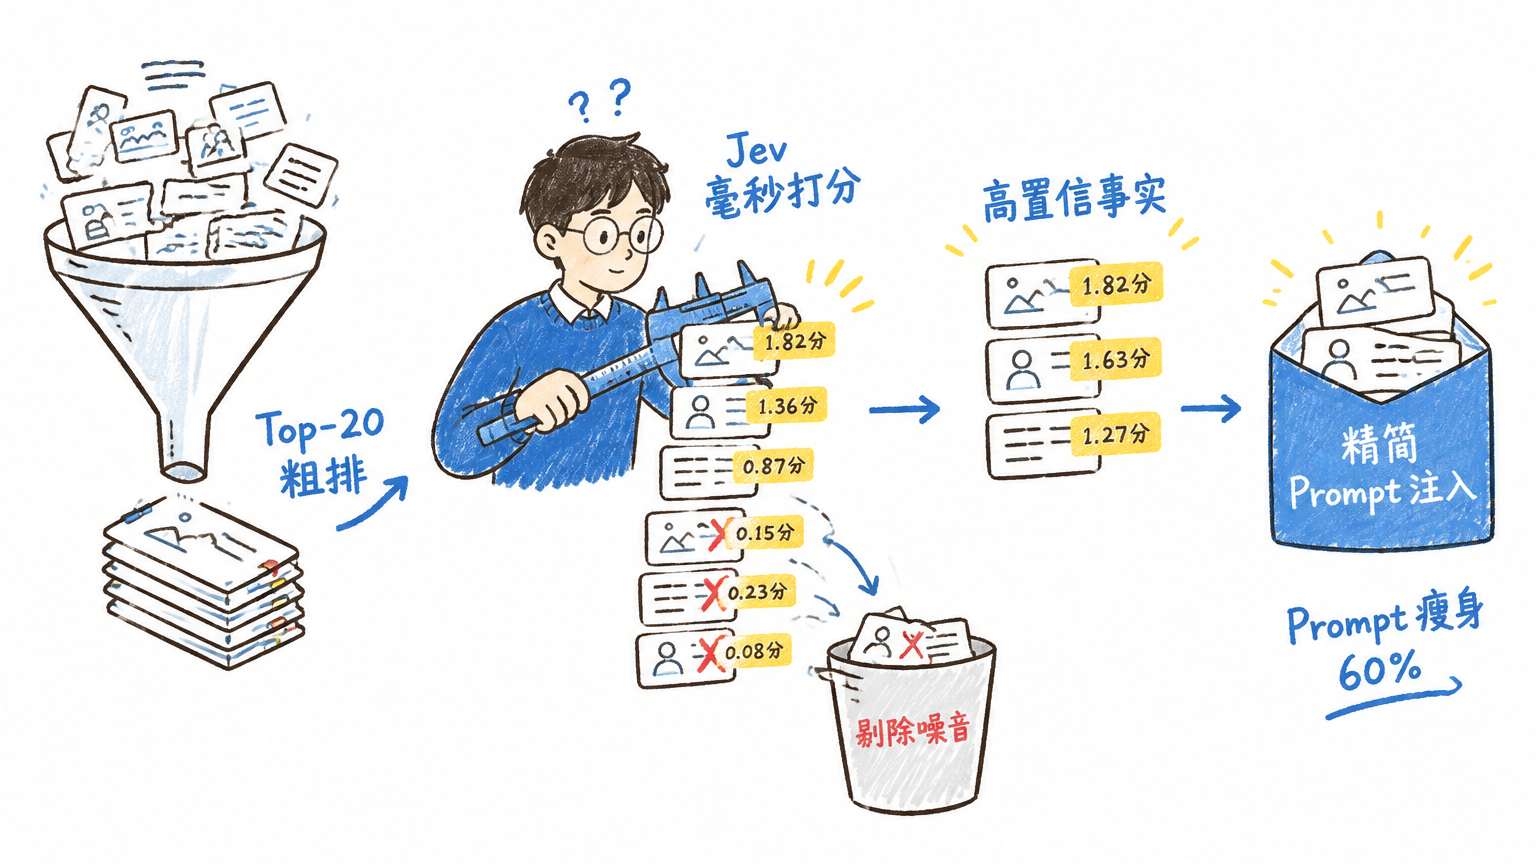
实测在数千条工程与业务记忆库中,Top-20 候选集里包含正确答案的概率往往能达到 90% 以上,但真正最关键的核心条目经常分散在第 5 到第 15 位。 - 全塞进 Prompt?上下文直接膨胀:
如果把召回的 10~20 条候选全作为背景注入,每轮对话白白浪费上千 Token,不仅拖慢首字生成时间(TTFT),还会稀释主模型的注意力(Lost in the Middle)。 - 用自回归 LLM 做重排?系统卡成幻灯片:
若让大语言模型逐条或批量做相关性打分重排,单次检索往往需要额外等待 2.0 ~ 2.5 秒,遇到并发场景极易触发限流,生成 Token 计费高昂。
传统的自回归 LLM 本质是慢思考(System 2),适合创造力、复杂长程推理;但记忆相关性重排属于封闭式状态评估,需要的其实是快反射(System 1)——毫秒级响应、强类型约束、且输出零生成成本。
这就是 Jev 切入的核心场景。
二、Jev 是什么?为什么是 System 1?
Jev(以及开源的 TypeSafe 架构)与传统大语言模型有着本质区别:
- 非自回归架构(Non-Autoregressive, NAR):它不依赖“逐字预测下一个 Token”的串行生成,而是在单次前向传播中完成并行判断;
- 极速推理(70~300ms):单次判定或并发多任务打分仅需百毫秒级,比传统 LLM 快一个数量级;
- 极度廉价:输入成本仅约
$0.042 / M tokens,输出完全免费; - 零 Schema 幻觉:直接输出校准得分(Score)或分类标签,天然类型安全。
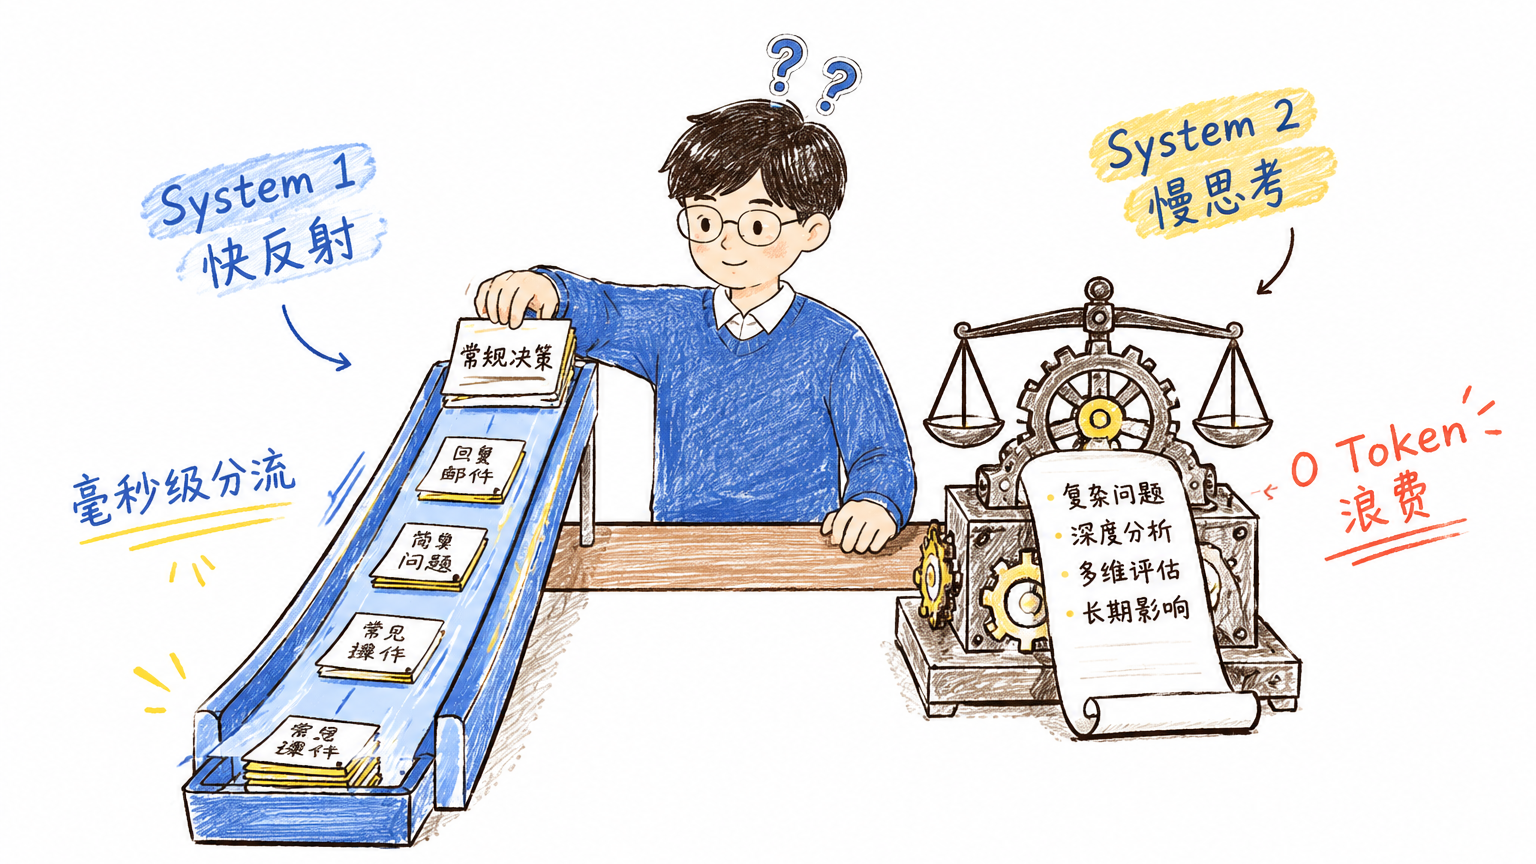
传统 Agent 架构(单脑全包):
[用户输入] ──> [LLM (System 2)] ──> [重排/长文本生成] (单步耗时 3~6s)

双层 Agent 架构(Jev + LLM 解耦):
[用户输入]
    │
    ├──> [Jev (System 1 快反射)] ──> 并发打分、高精度重排 (~150ms)
    │           │
    │           ▼ (精准截取前 3 条高置信度事实)
    └──> [LLM (System 2 慢思考)] ──> 复杂逻辑推理、综合答案生成 (省 Token、低延迟)
三、实战:用 Jev 毫秒级重构记忆重排
在传统向量检索拿到候选列表后,调用 Jev 的 Score 强类型原语进行并发打分,再按分数截取 Top-K 注入上下文:
import os
from typesafe_sdk import TypeSafeClient, Score

def jev_rerank_memories(query: str, raw_candidates: list[dict], top_k: int = 3) -> list[dict]:
    """利用 Jev 毫秒级对向量检索粗排候选进行精准重排"""
    client = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"])

    # 设定标准阶梯准则 (Rubric)
    rubric = [
        "与当前查询完全无关的噪音",
        "存在一定关联的技术背景或上下文,但非核心答案",
        "直接相关且提供了回答该问题的关键核心事实"
    ]

    # 构建并发评分题集:一次网络往返完成全部候选的打分
    questions = {
        f"m_{i}": Score(
            instructions=f"Query: {query}\nMemory: {item.get('content', '')}",
            criteria=rubric
        )
        for i, item in enumerate(raw_candidates)
    }

    resp = client.system_one(state={"query": query}, questions=questions)

    scored_items = []
    for i, item in enumerate(raw_candidates):
        ans = resp.answers.get(f"m_{i}")
        score_val = getattr(ans, "score", 0.0) if ans else 0.0
        scored_items.append((score_val, item))

    # 按校准得分降序排列并截取高置信度结果
    scored_items.sort(key=lambda x: x[0], reverse=True)
    return [item for _, item in scored_items[:top_k]]
四、真实测试对账与收益
在真实生产级别的记忆库中进行查询验证:
- 查询(Query):
"量化策略 回测 历史记录" - Jev 并发评分与重排结果:
- Score 1.82:
实盘标的 MNQ 历史回测表现:2 年累积收益 +$11,252,最大回撤 8.4%
(明确包含历史回测核心数据,直接命中首位) - Score 1.54:
用户在 8 月完成 OBI 均值回归变体策略回测,验证集胜率 44.2%
(包含回测完成记录与指标,高相关) - Score 1.20:
策略终版规则已通过本地 Tick 引擎 599 笔样本交叉验证
(验证证据链,强上下文关联) - Score 0.15:
生产数据库备份定时脚本已迁移至每周日凌晨执行
(系统运维记录,无关低分) - Score 0.00:
用户偏好 macOS 原生快捷键方案
(纯环境习惯,判定 0 分并彻底过滤)
- Score 1.82:
核心收益:
- 延迟骤降:传统 LLM 批量重排需 2,000~2,500ms,Jev 并发重排压降至 ~700ms(长连接下更快,提速超 65%)。
- 上下文深度瘦身:从无脑塞入 10~20 条粗排结果,精简为仅保留 3 条核心事实,每轮会话节省 60% 以上的无用字符,显著压低主模型首字延迟(TTFT)。
- 架构解耦:无需在服务器维护几十 GB 的 Cross-Encoder 显存占用,零部署负担。
五、总结
让 LLM 专注于生成,让 Jev 接管所有微决策。
Discussion