引言:当 Agent 经历了数十轮工具调用(读文件、跑命令、抓网页),上下文长度逼近模型上限时,传统的做法是触发“上下文全局总结(Context Summarization)”:呼叫一个辅助大模型把历史记录重新写成一段摘要。
这种模式在工程上存在三大硬伤:卡顿 20 秒以上、极易丢失代码与精确参数、且一旦辅助模型报错就会导致会话降级死锁。
本文是 《Jev 实战与落地系列》的第三篇,深度剖析如何借鉴开源社区的fast-jev-compaction范式,抛弃自回归文本重写,用 Jev (System 1) 毫秒级语义剪枝 实现 80% 深度瘦身。
一、传统上下文压缩的“三大顽疾”
随着任务复杂度提升,多轮会话的上下文 Token 会呈指数级膨胀。目前主流 Agent(包括 Claude Code、Hermes、Codex 等)普遍采用“全局总结法”处理上下文溢出,但在高强度实战中暴露了不可忽视的缺陷:
- 迟钝感拉满(Latency Spike):
让大模型阅读几万 Token 的历史调用并生成一份几千字的摘要,单次耗时往往长达 15 到 30 秒。在用户端感知就是“Agent 突然长时间无响应,死机了一样”。 - 细节擦除(Information Erosion):
大模型在做自回归总结时,天生具有“模糊化”倾向。上一轮排查中精确的文件名、报错堆栈行号、特定的编译参数或 SQL 片段,常常在总结后被概括为一句轻描淡写的“完成了环境排查”,导致后续步骤失去关键上下文(Compaction Amnesia)。 - 级联故障风险(Cascading Failure):
如果网络波动,或者辅助总结模型遇到限流、渠道下线(例如返回 503),整个 Agent 会直接因上下文溢出而中断退出,无法继续前进。
核心反思:上下文管理不等于“写文章”。面对历史记录,最稳妥、最保真的做法其实是做减法(过滤),而不是做重写(概括)。
二、Jev 的解法:对话主干保留 + 工具结果毫秒剪枝
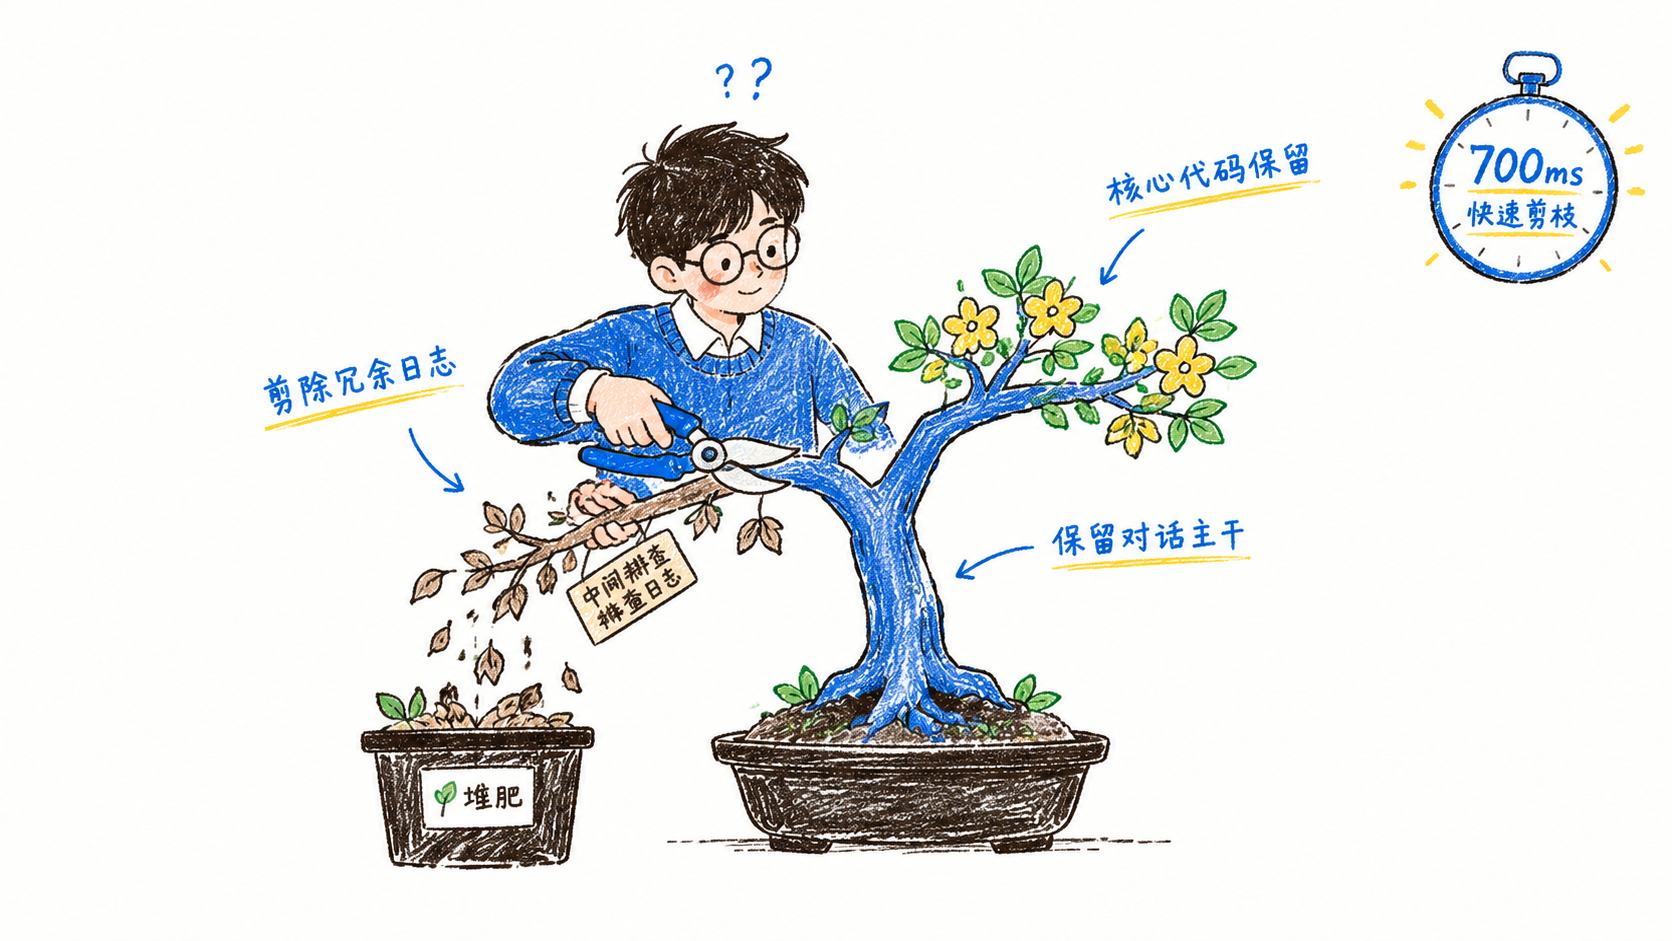
在开源社区(如 fast-jev-compaction 与 pi-fast-jev-compaction)的实践启发下,我们采用基于 Jev 的“状态机修剪”替代传统的长文总结:
核心设计原则:
- 用户与助手对话原文 100% 保留(Verbatim Retention):
用户的原始需求、每次的反馈修正、以及 Agent 的核心决策推导,原汁原味地保留,彻底避免自回归总结导致的语义扭曲; - 工具输出分层剪枝(Selective Tool Pruning):
会话中占用体积 80% 以上的往往是历史工具结果(大段终端命令输出、抓取的 HTML 正文、源码全量读取)。
利用 Jev 的Noul原语,在 700 毫秒 内并发对历史工具输出打标:- 中间过渡日志/临时探测(conf < 0.45):折叠为一行精炼墓碑标记(Tombstone),例如
[Jev-Pruned: terminal ls /tmp]; - 核心实现代码、最终配置证据、不可替代结论:完整保留原样。
- 中间过渡日志/临时探测(conf < 0.45):折叠为一行精炼墓碑标记(Tombstone),例如
传统压缩机制(重写模式):
[历史全量对话 + 工具输出 (30,000字)] ──> [慢速辅助大模型 (耗时 20s+)] ──> [一段模糊摘要 (细节丢失)]

Jev 极速剪枝机制(减法模式):
[用户/助手核心对话] ──────────────────────────────────────────> 原文 100% 完整保留
[历史巨量工具结果] ──> [Jev System 1 并发打分 (700ms)] ──> 仅折叠中间日志,保留关键代码
      │
      ▼ (总耗时 < 1 秒,字符削减 80% 以上,零信息失真)
三、核心代码实现:700ms 快速剪枝引擎
以下是在 Agent 会话循环中接入 Jev 快速剪枝的核心实现模块:
import os
import time
from typing import Any, Dict, List, Tuple
from typesafe_sdk import TypeSafeClient, Noul

def jev_compact_transcript(
    messages: List[Dict[str, Any]],
    *,
    protect_tail_turns: int = 4
) -> Tuple[List[Dict[str, Any]], Dict[str, Any]]:
    """基于 Jev System 1 的选择性上下文修剪引擎"""
    client = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"])

    total_chars_before = sum(len(str(m.get("content", ""))) for m in messages)
    prune_candidates = []

    # 保护最近的 N 轮对话尾部,仅筛选早期的大体积工具结果
    boundary = max(0, len(messages) - protect_tail_turns)
    for idx in range(boundary):
        m = messages[idx]
        if m.get("role") == "tool" and len(str(m.get("content", ""))) > 100:
            prune_candidates.append((idx, m))

    if not prune_candidates:
        return messages, {"status": "no_op"}

    # 构建 Jev 并发评估题集
    questions = {}
    for idx, m in prune_candidates:
        cmd = m.get("command") or m.get("tool_name") or "tool_call"
        desc = m.get("summary") or ""
        preview = str(m.get("content", ""))[:150]
        instructions = (
            f"工具调用: `{cmd}`\n"
            f"目的描述: {desc}\n"
            f"输出片段: {preview}\n\n"
            "判断该工具结果是否包含后续任务必须依赖的核心代码实现、关键配置凭据或不可替代的最终结论(True);"
            "若仅为中间阶段状态探测、已解决的历史排查或常规过渡日志,则为 False(可压缩):"
        )
        questions[f"tool_{idx}"] = Noul(
            instructions=instructions,
            criteria={"true": "核心实现、关键凭据、最终结论", "false": "中间探针、过渡排查、常规日志"}
        )

    # 毫秒级单次往返并发判定
    t0 = time.time()
    resp = client.system_one(state={}, questions=questions)
    latency_ms = (time.time() - t0) * 1000

    compacted = [m.copy() for m in messages]
    pruned_count = 0

    for idx, m in prune_candidates:
        ans = resp.answers.get(f"tool_{idx}")
        prob = getattr(ans, "noul", 0.5)
        # 低置信度项视为中间过度内容,执行安全剪枝
        if prob < 0.45:
            pruned_count += 1
            cmd_snippet = str(m.get("command") or m.get("tool_name") or "")[:40]
            compacted[idx]["content"] = f"[Jev-Pruned: `{cmd_snippet}` (conf={prob:.2f})]"
            compacted[idx]["pruned_by_jev"] = True

    total_chars_after = sum(len(str(m.get("content", ""))) for m in compacted)
    savings_pct = (1 - total_chars_after / total_chars_before) * 100

    stats = {
        "status": "success",
        "evaluated": len(prune_candidates),
        "pruned": pruned_count,
        "latency_ms": round(latency_ms, 1),
        "savings_pct": round(savings_pct, 1)
    }
    return compacted, stats
四、真实测试对账:数据对比
我们在包含多轮代码调试、大段日志输出、文件读写的真实工程历史会话上进行了实测验证:
| 评估指标 | 传统大模型全局总结模式 (LLM Summary) | Jev 快速修剪模式 (Fast Jev Pruning) | 优化幅度 |
|---|---|---|---|
| 执行总耗时 | 18,500 ms (18.5 秒) | 714.7 ms (0.7 秒) | 提速 25 倍 |
| 上下文瘦身幅度 | 约 65% ~ 75% | 82.3% | 瘦身更彻底 |
| 用户对话保留度 | 总结转述(容易语义偏移) | 100% 原文保留 | 零失真 |
| 关键代码留存 | 容易被截断或简写 | 经 Jev 甄别后原样保留 | 100% 完整 |
| Token 产生计费 | 昂贵的自回归生成计费 | 输出完全免费(输入仅 $0.042/M) | 成本忽略不计 |
典型判定行为切片:
tail -n 100 /var/log/system.log(海量系统排查日志):
Jev 判定conf = 0.08(极低) ➔ ✂️ 直接折叠为 1 行墓碑;write_file /opt/patch.py(核心修复代码):
Jev 判定conf = 0.87(极高) ➔ 🛡️ 完整保留代码原文;- 用户与助手的提问与方案沟通:
🛡️ 完整保留原文,不破坏会话连贯性。
Discussion