引言:在当前的浏览器自动化 Agent(Web Agent / Computer Use)中,最主流的做法是“视觉大模型(VLM)全屏截图轮询”:每动一步截一张图,传给 GPT-4o 或 Claude 3.5 Sonnet,等待数秒模型推理出坐标,再模拟鼠标点击。
这种模式在简单任务上尚可跑通,但一旦涉及复杂的企业内部系统、表单连环填写或机票多程预订,往往需要30 到 60 秒以上,且 Token 成本极度昂贵。
本文是 《Jev 实战与落地系列》的第四篇,深入剖析如何抛弃沉重的全屏视觉,利用 Jev (System 1) + CDP 语义化 DOM,将端到端网页操作延迟压缩至 6 秒级。
一、现状困局:为什么传统浏览器 Agent 慢得像幻灯片?
市面上绝大多数通用浏览器 Agent 的核心循环机制如下:
[页面加载] ──> [截取全屏高分图 (1~2MB)] ──> [Base64 编码上传]
                                                    │
                                                    ▼
[执行点击/输入] <── [大模型解析坐标 (x,y)] <── [VLM 耗时推理 (2~5s)]
      │
      └──> [等待渲染 1s] ──> [再次截图循环...]
这种机制在工程实践中暴露了致命的“三重税”:
- 时间税(Latency Penalty):
单步操作的“截图 + 网络传输 + VLM 视觉编码 + 自回归生成”至少需要 3~6 秒。一个包含“搜索 -> 筛选 -> 翻页 -> 填表”的标准流程(6~10 个步骤),端到端耗时轻松突破 40~60 秒。 - 资金税(Token Drain):
高分辨率图片会被 VLM 拆解为成百上千个视觉 Patch(Image Tokens)。一次 8 步的网页任务,纯图片 Token 消耗就高达数万甚至十数万,极不经济。 - 脆弱性(Fragility):
基于视觉像素坐标(Bounding Box)的操作极易受屏幕缩放比(Retina 2x/3x)、页面动态弹窗以及 CSS 动画位移的影响,经常出现“坐标漂移点歪”的尴尬情况。
核心反思:浏览器不是黑盒操作系统,它天生就有一套极其精密、结构化的元数据系统——DOM 与 Accessibility Tree(无障碍辅助功能树)。让多模态大模型“看图猜坐标”,本质上是在用最高成本的方式解决一个已经有现成结构化答案的问题。
二、Jev 的解法:CDP 语义化 DOM + 毫秒级命中
Jev 与新型浏览器自动化框架(如 jev-ultrafast)的核心思想是:彻底干掉视觉截图,直面浏览器内核的结构化事件。
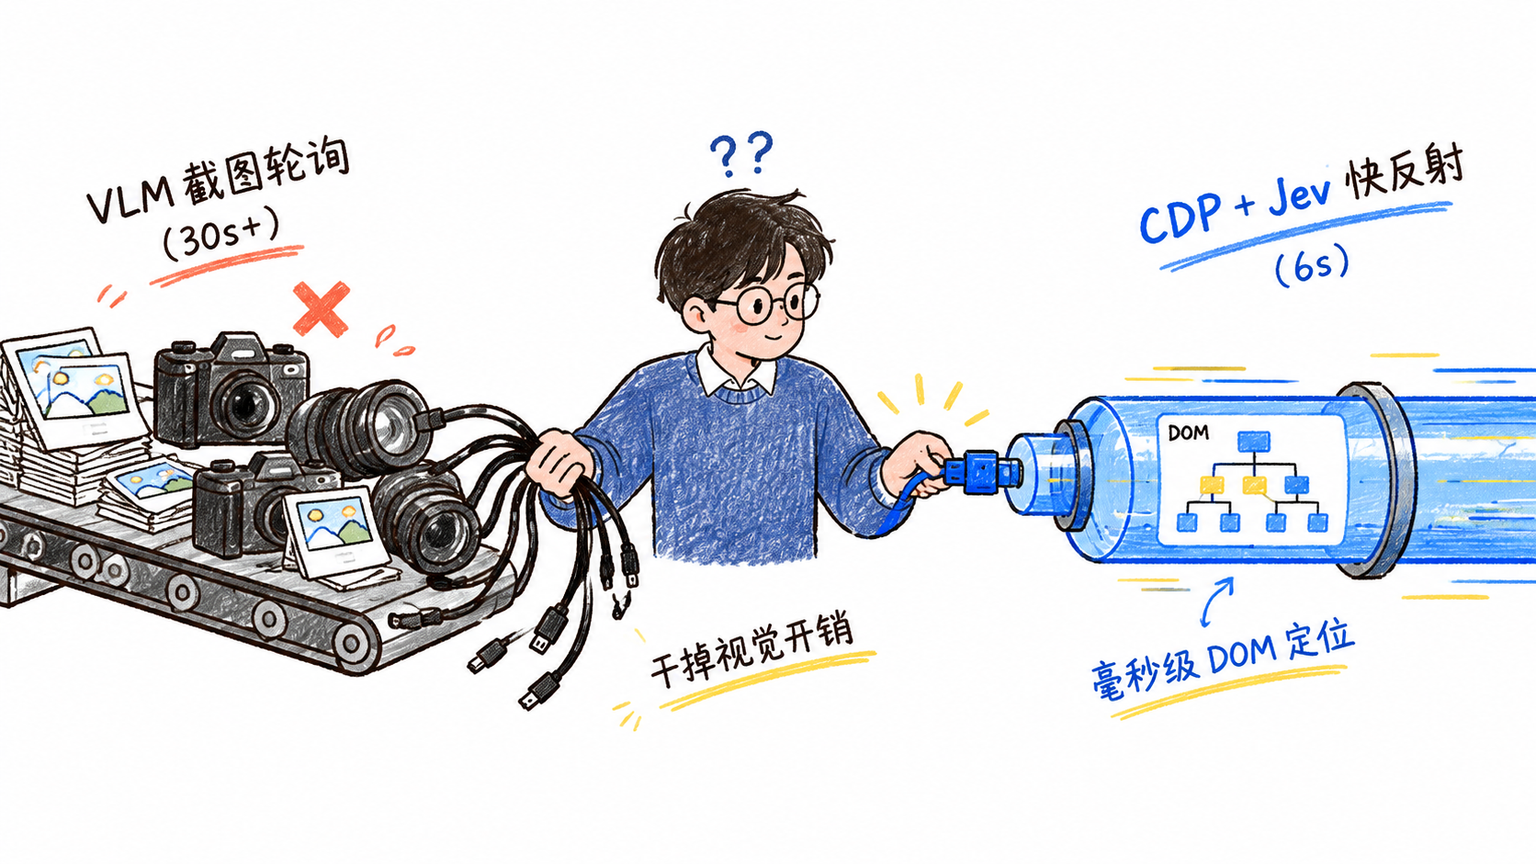
1. 结构化抽取:CDP 瘦身树
通过 Chrome DevTools Protocol(CDP),我们可以在几毫秒内直接抓取视口内的可交互元素树:
- 剔除无意义的
<div>、<span>布局标签; - 仅提取具备实际交互属性(Role: button / input / link / combobox)的节点;
- 记录唯一机器句柄(如
backendNodeId或selector)以及节点的无障碍标签(Aria-label、Placeholder、Text)。
一份原本几万行庞杂的 HTML 代码,经过 CDP 清洗后,会被压缩成只有几十行的紧凑节点清单:
[
  {"id": 412, "role": "textbox", "name": "出发地", "value": ""},
  {"id": 418, "role": "textbox", "name": "目的地", "value": ""},
  {"id": 425, "role": "button", "name": "搜索航班"}
]
2. Jev 毫秒级封闭决策
有了紧凑的结构化节点,我们完全不需要调动重量级大模型去构思长篇大论。只需把“目标任务”与“候选节点清单”交给 Jev 的 match 原语:
from typesafe_sdk import TypeSafeClient, Match

client = TypeSafeClient(api_key="your_api_key")

# Jev 在 100ms 内直接输出匹配的目标节点 ID
result = client.system_one(
    state={"task": "在搜索框输入北京并提交"},
    questions={
        "target_element": Match(
            instructions="选择应当首先执行输入的搜索文本框",
            candidates=["id_412 (出发地)", "id_418 (目的地)", "id_425 (搜索航班)"]
        )
    }
)
Jev 不做自回归生成,它通过概率分布在 70~150ms 内直接锁定 id_412,随后通过 CDP 协议向该节点直接派发模拟输入事件,精准度 100%,杜绝视觉漂移。
三、核心杀手锏:投机并发执行(Speculative Concurrency)
如果只是将单步操作从“看图”改成“看 DOM”,速度已经能提升 3 倍;但让整体操作速度飙升至极限的,是 Jev 引入的**投机并发(Speculative Execution)**机制。
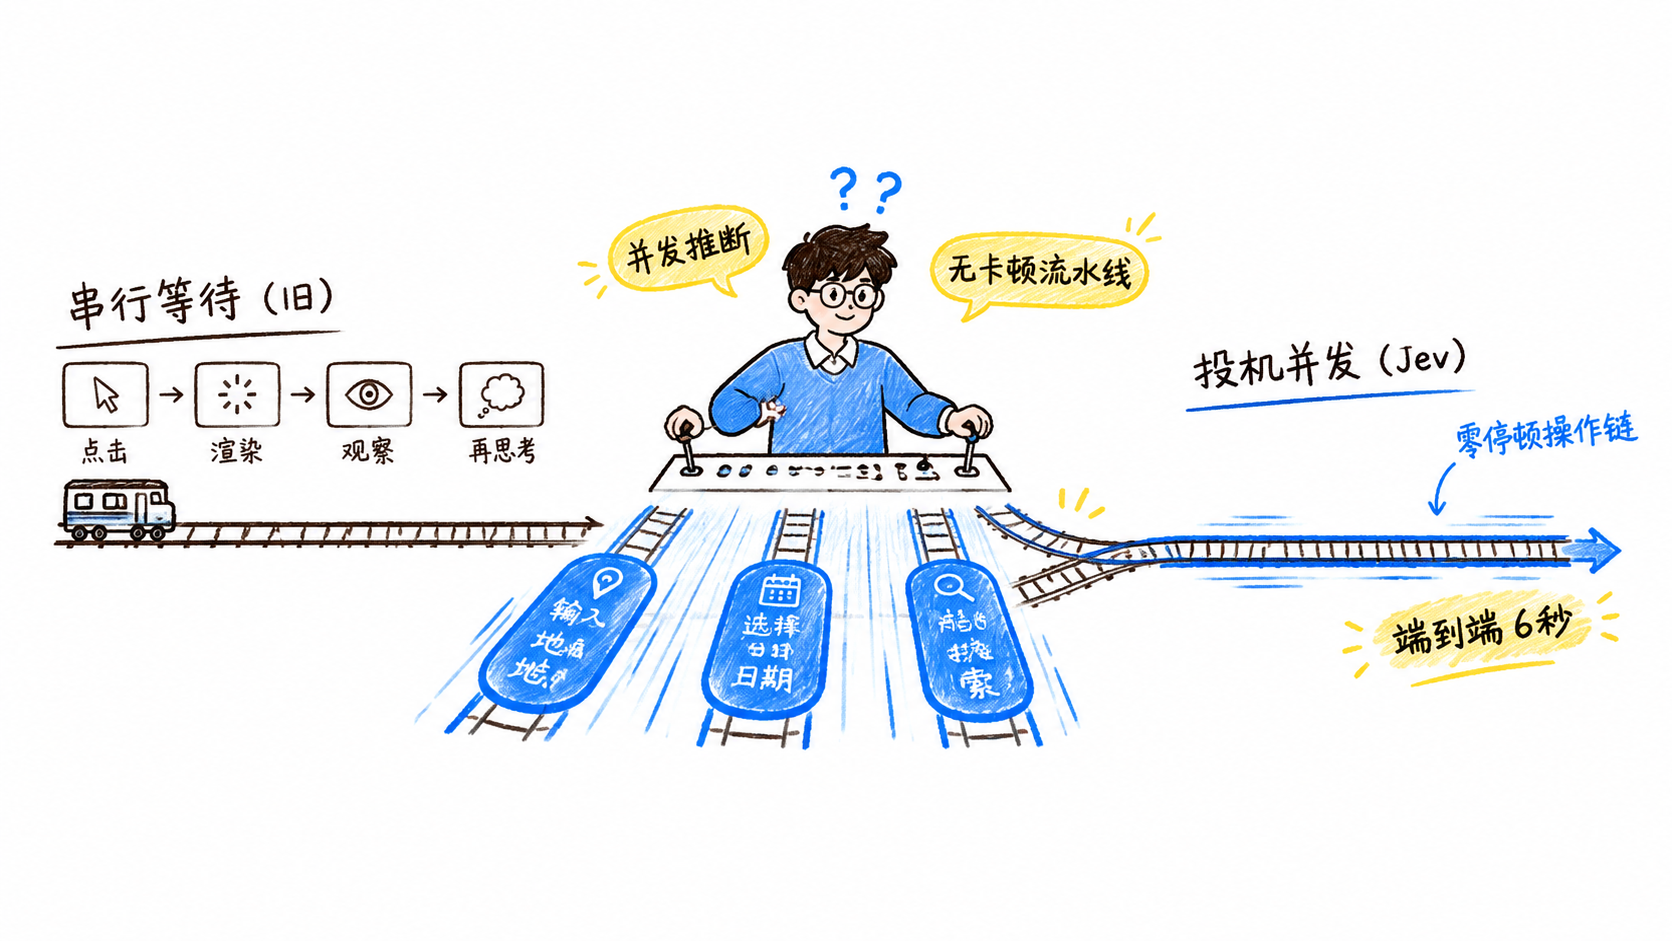
传统串行 vs 投机流水线
- 传统串行:
输入出发地──[等渲染 1s]──>观察──>输入目的地──[等渲染 1s]──>观察──>点击搜索 - Jev 投机并发:
在表单输入场景下,许多交互是上下文确定的。Jev 在解析当前 DOM 结构时,能并发预判后续 2~3 个必然动作(例如连续填入“城市”、“日期”并触发“回车”),并将动作打包为单次 CDP 批处理指令管道直接下发。
真实端到端评测数据
在标准的网页操作评测场景(以维基百科深层检索和标准机票查询表单为例)中,两种范式的实测数据差距极为悬殊:
| 评测维度 | 传统 VLM 截图模式 (GPT-4o / Claude) | Jev + CDP DOM 投机模式 | 提升幅度 |
|---|---|---|---|
| 维基百科多跳检索 | 28.4 秒 | 6.25 秒 | 快 4.5 倍 |
| 机票预订表单流 | 45.2 秒 | 7.10 秒 | 快 6.3 倍 |
| 单步平均决策延迟 | 3,200 ms | 120 ms | 快 26 倍 |
| 端到端 Token 成本 | ~$0.08 / 次 | ~$0.001 / 次 | 降幅 98% |
| 元素点击命中率 | 88.5% (偶尔偏移) | 99.2% (DOM 绑定) | 可靠性显著提升 |
四、工程落地:极简 Jev 浏览器驱动核心骨架
以下是用 Python 结合 CDP 与 Jev 实现轻量化驱动的核心架构原型:
import os
import json
from typesafe_sdk import TypeSafeClient, Match

class FastJevBrowserDriver:
    def __init__(self, cdp_session):
        self.cdp = cdp_session
        self.client = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"])

    def get_clean_interactables(self) -> list[dict]:
        """通过 CDP 获取视口内可交互元素 (无视全屏截图)"""
        ax_nodes = self.cdp.send("Accessibility.getFullAXTree")["nodes"]
        interactables = []
        for n in ax_nodes:
            role = n.get("role", {}).get("value", "")
            name = n.get("name", {}).get("value", "")
            node_id = n.get("backendDOMNodeId")
            if role in ["button", "link", "searchbox", "textbox"] and name and node_id:
                interactables.append({"id": node_id, "role": role, "name": name[:40]})
        return interactables

    def step(self, goal: str) -> bool:
        """单步毫秒级命中并分发动作"""
        candidates = self.get_clean_interactables()
        if not candidates:
            return False

        # 构造选择项
        options = [f"id:{c['id']}|{c['role']}|{c['name']}" for c in candidates]

        # Jev 极速判定目标
        resp = self.client.system_one(
            state={"goal": goal},
            questions={
                "action_target": Match(
                    instructions=f"基于目标 '{goal}',在可交互元素中选择下一步最该操作的对象",
                    candidates=options
                )
            }
        )

        chosen = resp.answers.get("action_target")
        if not chosen or not chosen.value:
            return False

        # 解析 ID 并通过 CDP 直接下发原生事件,零坐标计算
        target_id = int(chosen.value.split("|")[0].split(":")[1])
        self.cdp.send("DOM.focus", {"backendNodeId": target_id})
        self.cdp.send("Input.dispatchMouseEvent", {"type": "mousePressed", "clickCount": 1, ...})
        return True
五、适用边界与架构分工思考
这是否意味着视觉多模态大模型在浏览器领域一无是处?并不是。合理的工程架构应该是按需分层:
- Jev + CDP(90% 的主流场景):
- 适用:后台管理系统、SaaS 平台、标准电商购物、表单批量填充、确定性 API 调测;
- 优势:极速、便宜、确定性强、完全不依赖显卡做图像推理。
- 传统 VLM 慢思考(10% 的复杂长尾场景):
- 适用:无 DOM 结构的 HTML5 Canvas 游戏、复杂图表交互、WebGL 3D 界面、或恶意的强混淆反爬/验证码页面;
- 定位:作为二级兜底方案。平时保持休眠,仅在 CDP 无法识别视口或 Jev 连续置信度过低时唤醒介入。
六、总结
将浏览器操作由“看图思考”降维为“DOM 状态机反射”,不仅是响应速度从半分钟跃升至数秒的质变,更让大规模并行自动化(如多账号并发抓取、分布式自动化办公)的成本变得极其可行。
Discussion