引言:许多开发者在给 Agent 搭建记忆系统时,往往只重视“怎么检索”,却忽视了“源头治理”。如果 Agent 在多轮对话中把随口一说的即时报错、临时状态当成长久事实写入,或者同一条偏好反复录入,久而久之向量库就会被严重污染。
本文是 《Jev 实战与落地系列》的第二篇,聚焦如何利用 Jev (System 1) 的布尔校准概率,在记忆写入链路前设立“防噪音”与“防重复”的双重毫秒级安检门。
一、写入端的隐形灾难:脏记忆与语义冗余
在生产环境中,Agent 自动沉淀记忆(无论是通过显式工具调用 mem0_add 还是后台会话自动提取)常常面临两大棘手问题:
- 瞬态噪音污染(Transient Chatter & Errors):
在调试排错或闲聊时,用户或 Agent 经常产生一次性状态(如“刚才网络连接超时”、“测试返回码是 200”、“喝了口咖啡”)。若未经筛选直接持久化,向量库的有效信噪比会急剧下降,未来检索时频频冒出来干扰。 - 跨语言与同义重复(Duplicate Redundancy):
用户在前天可能录入了一条英文规则:"Surge proxy routes N through a Singapore node...";今天在对话中又提到:"访问 N 必须分流至新加坡节点"。如果只做简单的关键词匹配,系统会把两者当成全新事实重复存入,导致库内充斥冗余事实。
如果每次写入都唤醒大模型去做综合语义审校,不仅成本吃不消,而且写操作延迟会显著增加。我们需要的是一个毫秒级、成本趋近于零的守门人(Gatekeeper)。
二、Jev 双重质检门架构
基于 Jev 的 Noul(Yes/No 布尔校准概率原语),我们在记忆写入底层构建了双重质检机制:
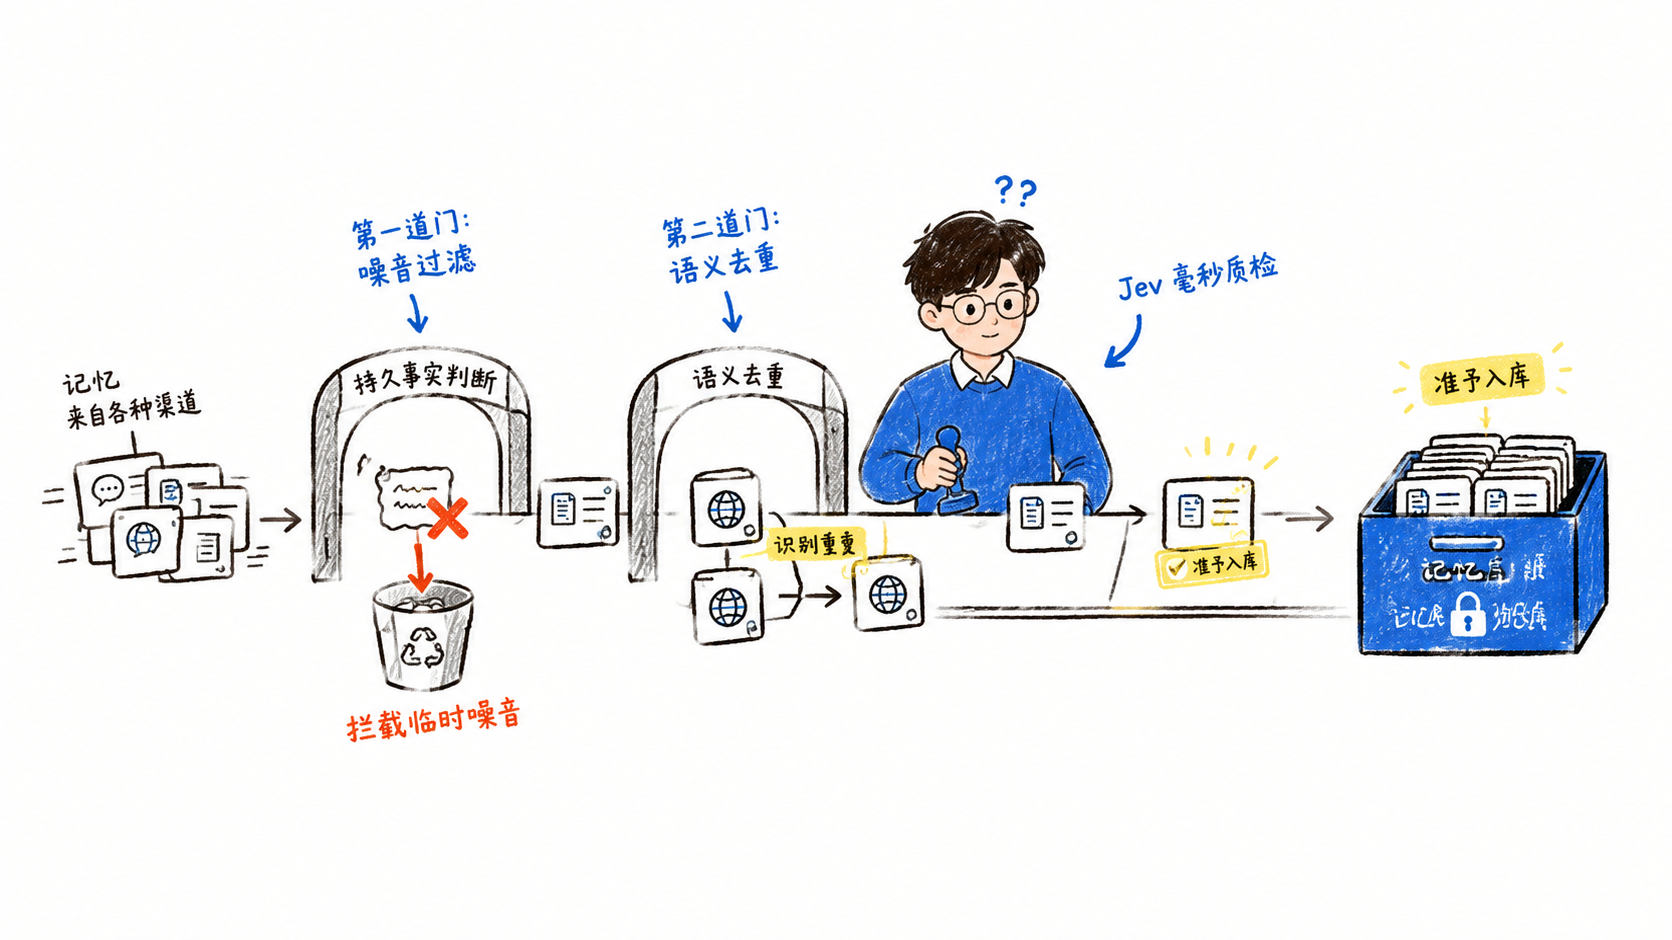
[新提取的事实]
      │
      ▼
【第一道门:持久事实判定】
      │
      ├──> [durable_prob < 0.35] ──> 🚫 [拦截临时噪音/闲聊] (不入库)
      │
      └──> [通过] ──> 向量库轻量召回最相似候选 (Top-3)
                            │
                            ▼
                     【第二道门:语义去重对比】
                            │
                            ├──> [dup_prob > 0.85] ──> 🚫 [拦截并合并重复]
                            │
                            └──> [通过] ──> ✅ [写入持久记忆库]
三、核心代码实现
在自建记忆后端(或 Agent 记忆插件的 add 钩子)中,无侵入嵌入 Jev 质检逻辑:
import os
from typesafe_sdk import TypeSafeClient, Noul

def jev_ingestion_gate(client: TypeSafeClient, content: str, memory_backend, user_id: str) -> tuple[bool, str]:
    """记忆入库前双重质检:1. 过滤临时噪音;2. 跨语言语义去重"""

    # 闸门一:持久事实判定 (Durable Filter)
    resp_dur = client.system_one(
        state={},
        questions={
            "durable": Noul(
                instructions=f"判断以下内容是否为长期有效的用户偏好、配置规范或业务关键事实(True);若是临时对话、一次性操作状态、即时报错或无关闲聊则为 False:\n内容:{content}",
                criteria={"true": "长期有价值的规则、偏好、架构事实", "false": "临时状态、即时报错、闲聊客套"}
            )
        }
    )
    durable_prob = getattr(resp_dur.answers.get("durable"), "noul", 1.0)
    if durable_prob < 0.35:
        return False, f"Filtered by Jev: Content classified as transient/non-durable (confidence={durable_prob:.2f})"

    # 闸门二:语义去重检测 (Deduplication Filter)
    candidates = memory_backend.search(content, filters={"user_id": user_id}, top_k=3, rerank=False)
    if candidates:
        top_mem = candidates[0].get("memory", "")
        resp_dup = client.system_one(
            state={},
            questions={
                "dup": Noul(
                    instructions=f"已有记忆:{top_mem}\n\n新事实:{content}\n\n判断新事实是否与已有记忆存在语义实质重复(信息已完全包含在已有记忆中):",
                    criteria={"true": "实质重复,信息已存在", "false": "全新事实,或包含重大未记录的新信息"}
                )
            }
        )
        dup_prob = getattr(resp_dup.answers.get("dup"), "noul", 0.0)
        if dup_prob > 0.85:
            return False, f"Deduplicated by Jev: Substantially identical fact already exists ('{top_mem[:40]}...')"

    return True, "Passed"
四、真实环境测试对账
我们在真实的 Agent 记忆数据库上进行了多组闭环测试,Jev 的校准概率给出了极高的判决置信度:
| 测试场景 | 尝试写入的内容 | Jev 质检判定 | 处置结果 |
|---|---|---|---|
| 一次性排查噪音 | "刚才测试了一下 ping 命令,延迟是 20ms" |
durable_prob = 0.04 (极低) |
🚫 自动拦截,免除污染 |
| 跨语言语义重复 | "Surge 代理配置:访问 N 必须分流至新加坡节点"(库内已有: "Surge proxy routes N through a Singapore node...") |
dup_prob = 0.96 (极高) |
🚫 拦截去重,直接提示已有事实 |
| 有效新业务规则 | "系统配置验证规则:所有后台 Python 脚本必须显式声明 UTF-8 编码" |
durable_prob = 0.85, dup_prob = 0.02 |
✅ 安全放行,成功落盘 |
收益总结:
- 源头洁净化:彻底阻断瞬态无用数据,保证沉淀进长期记忆库的每一条事实都具备长久参考价值;
- 多语言去重:无需人工维护复杂的黑名单或正则,Jev 自然具备跨语言、跨表述的语义判重能力;
- 极速与零成本:两次判定总耗时在 150ms 左右,输出完全免费,兼具极佳的工程鲁棒性。
Discussion